Gemini Omni Resmi Diperkenalkan: Model AI Google yang Bisa Edit Video Lewat Perintah Suara
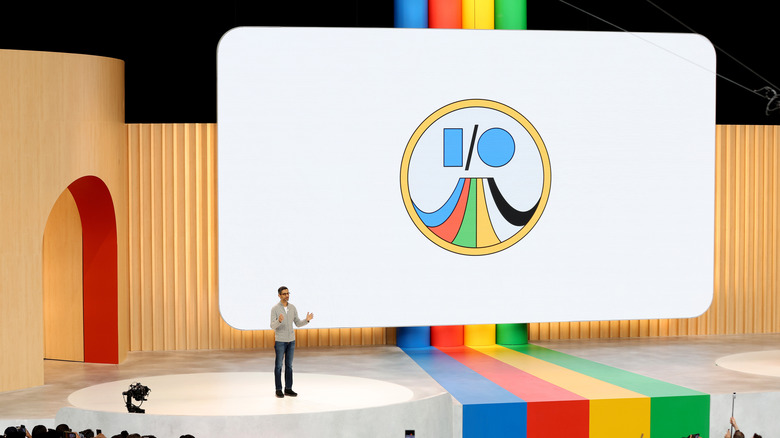
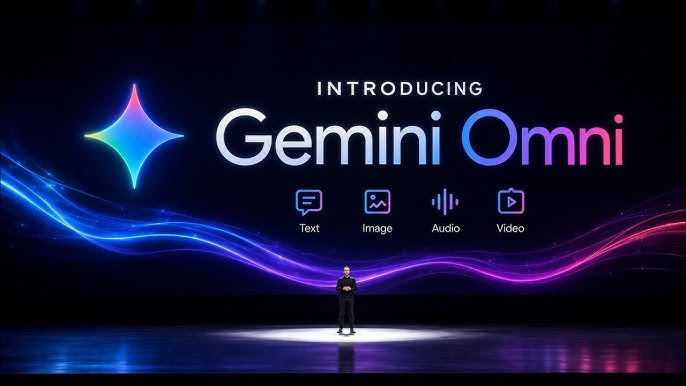
INFO TEKNO> Google memperkenalkan Gemini Omni di panggung Google I/O 2026—keluarga model multimodal baru yang dirancang untuk pembuatan dan pengeditan video berbasis AI melalui perintah percakapan alami. Model pertama dari lini ini, Gemini Omni Flash, mulai diluncurkan hari ini ke aplikasi Gemini, Google Flow, dan YouTube Shorts.
Diumumkan Demis Hassabis, Dibangun di Atas Model Dunia DeepMind
Pengumuman Gemini Omni disampaikan langsung oleh Demis Hassabis, CEO Google DeepMind, dalam pidato utama Google I/O 2026. Hassabis memposisikan Omni sebagai kelanjutan logis dari keahlian bertahun-tahun DeepMind dalam pengembangan world model—sistem AI yang tidak sekadar memproses teks, melainkan memodelkan dan mensimulasikan realitas secara aktif.
Tujuan jangka panjang yang ditetapkan Hassabis untuk Omni sangat ambisius: menghasilkan semua jenis output dari semua jenis input. Itu berarti satu model yang mampu menerima gambar, audio, video, dan teks secara bersamaan—lalu memproduksi output dalam format apa pun yang diminta pengguna.
CEO Google Sundar Pichai menambahkan konteks strategis dalam pidato yang sama. “Ketika kami pertama kali mengumumkan Gemini, itu adalah model AI pertama kami yang secara bawaan bersifat multimodal,” ujar Pichai. “Kami tahu bahwa melatihnya dengan kombinasi teks, kode, audio, gambar, dan video akan memberinya pemahaman yang lebih dalam tentang dunia. Dengan model dunia, AI bergerak dari memprediksi teks ke mensimulasikan realitas. Gemini Omni adalah langkah selanjutnya ke arah itu.”
Cara Kerja: Pengeditan Percakapan dan Pemahaman Konteks Dunia Nyata
Fitur utama yang membedakan Gemini Omni dari model generasi video konvensional adalah pengeditan percakapan—kemampuan mengedit elemen video menggunakan perintah suara alami tanpa perlu antarmuka pengeditan tradisional.
Pengguna dapat mengubah karakter, mengganti latar belakang, memodifikasi aksi, menambahkan objek baru, atau mengubah sudut pandang—semuanya cukup dengan instruksi verbal. Google mendeskripsikan pendekatan ini dengan cara yang menarik: “Video Anda menjadi titik awal untuk sesuatu yang tidak mungkin Anda rekam sendiri.”
Kemampuan ini dimungkinkan oleh pemahaman kontekstual yang lebih dalam. Gemini Omni dilatih dengan pengetahuan tentang fisika, budaya, sejarah, dan sains—bukan hanya pola visual—sehingga output yang dihasilkan lebih realistis dan kontekstual secara situasional. Sistem ini memahami bahwa objek memiliki berat, cahaya memiliki arah, dan karakter memiliki konsistensi visual yang harus dipertahankan lintas
Aaf Afiatna (Aura OS) adalah seorang WordPress Developer, Administrator IT, dan penggerak di balik infrastruktur berbagai portal media digital PT Arina Duta Sehati. Ia memiliki ketertarikan mendalam pada rekayasa sistem tingkat rendah, implementasi AI on-device, dan pengembangan proyek open-source seperti Neural Standby Kernel (NSK). Saat tidak sedang berurusan dengan server atau kode, ia aktif mengeksplorasi ekosistem Web3 dan berbagi wawasan melalui channel YouTube CryptoFansWorld.